32비트 / 64비트 운영체제 아키텍쳐는 무슨 차이일까
프로그램을 다운로드 받을 때, CPU 가 인텔 것 인지, 애플 실리콘 칩인지 구분하여 받는 것처럼 시스템 아키텍쳐가 32비트 인지, 64비트인지 구분하여 다운로드 받을 수 있도록 되어있다. 이 둘은 어떤 차이길래 소프트웨어 설치 시 구분되어 설치하도록 되어있는 것 일까?
먼저 한 가지 이유를 비유를 통해 쉽게 알아보자
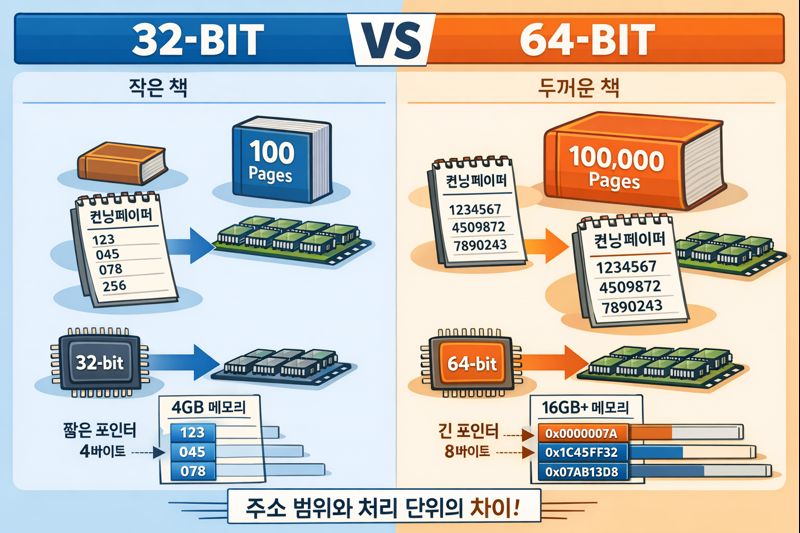
1. 비유로 이해하기: 컨닝페이퍼와 책
컴퓨터가 메모리를 다루는 방식은, 시험장에서 책을 펼쳐 참고하면서 문제를 푸는 상황(오픈북 시험)으로 비유해볼 수 있다.
- 책: 메모리(혹은 데이터가 담긴 거대한 저장 공간)
- 페이지 번호: 주소(address)
- 컨닝페이퍼: CPU 캐시(혹은 CPU가 가까이 두고 자주 쓰는 빠른 공간)
- “다음에 참고할 페이지 번호 목록”: 포인터(pointer)
- 32비트는 “페이지 번호가 짧은 시대”
책이 100페이지짜리였다면, 페이지 번호는 길어야 3자리다.
컨닝페이퍼에 “참고 페이지 번호”를 적을 때도 짧게 적을 수 있으니, 한 장에 많이 적어둘 수 있다.
- 64비트는 “책이 두꺼워진 시대”
요즘은 책이 100,000페이지가 될 수 있다. 그러면 페이지 번호가 길어지고(자리 수가 늘어나고), 컨닝페이퍼 한 장에 적을 수 있는 페이지 번호 개수는 줄어든다.
여기서 중요한 포인트가 하나 있다.
캐시는 “책 전체 범위를 넓게 커버하는 지도”가 아니라,
최근에 본 페이지 몇 장을 통째로 들고 있는 컨닝페이퍼에 가깝다.
따라서 페이지 번호(포인터)가 길어지면, 같은 크기의 컨닝페이퍼에 담을 수 있는 “참조 정보”가 줄고, 결국 책을 다시 펼쳐보는 횟수(캐시 미스)가 늘어날 수 있다.
2. “그럼 32비트가 항상 더 빠른가?”
비유만 들으면 “포인터가 짧은 32비트가 더 효율적인 거 아닌가?”라고 생각하기 쉬운데, 결론은 이렇다.
- 32비트가 유리할 때가 ‘있다’: 포인터 비중이 큰 자료구조(트리/리스트/객체 참조가 많은 구조)에서 메모리 footprint가 줄어 캐시 효율이 좋아질 수 있음
- 하지만 대부분의 현대 환경에서 64비트가 표준인 이유가 있다: 더 큰 주소 공간, 레지스터/연산 확장, 시스템 생태계 최적화 등으로 종합 이득이 큰 경우가 많음
즉, “32비트가 작고 빠르다”는 말은 특정 조건에서만 성립한다.
3. 32비트/64비트의 차이는 무엇인가
3.1 워드 크기(레지스터 폭) 차이
32비트/64비트의 근본은 CPU가 기본으로 다루는 단위(워드)가 다르다는 점이다.
- 32비트 CPU: 레지스터(일반 목적 레지스터)가 32비트 폭
- 64비트 CPU: 레지스터가 64비트 폭
- 영향
- 64비트 정수 연산(큰 카운터, 암호/해시 등)을 더 자연스럽고 효율적으로 처리하는 경우가 많다.
- 반대로 64비트는 데이터 구조가 커져 캐시 효율이 불리해질 수 있다.
3.2 주소 공간(가상 주소/물리 주소) 차이
많이 알려진 차이: “프로세스가 접근 가능한 메모리 주소 범위”
- 32비트 주소는 이론상 2³² 바이트 ≈ 4GiB
- 실제로는 커널 영역/예약 영역/MMIO 등으로 유저 프로세스가 전부를 쓰지 못하는 경우가 흔하다.
64비트는 주소 표현 범위가 훨씬 넓어져, 현대 시스템처럼 메모리/데이터 규모가 커진 환경에서 구조적 한계를 크게 줄인다.
3.3 포인터 크기 변화와 ABI(호출 규약) 변화
포인터는 “주소를 담는 변수”다.
- 32비트 환경: 포인터가 보통 4바이트
- 64비트 환경: 포인터가 보통 8바이트
이 차이가 단순히 메모리를 더 쓰는 문제로 끝나지 않는다.
- 구조체/클래스의 크기 증가 및 정렬(alignment) 변화
- 함수 호출 규약(ABI), 라이브러리 바이너리 호환성 변화
- 결국 “32비트 프로그램”과 “64비트 프로그램”이 구분되는 이유가 된다.
3.4 캐시 적중률과의 관계: 왜 포인터가 크면 불리할 수 있나
캐시는 보통 캐시 라인(예: 64바이트) 단위로 데이터를 가져온다.
- 포인터 4바이트라면 64바이트에 더 많이 들어간다.
- 포인터 8바이트면 같은 라인에 들어가는 개수가 줄어든다.
즉, 포인터/참조가 많은 자료구조에서는
- 데이터 구조가 커지고
- 같은 개수의 노드를 처리할 때 캐시 라인/페이지 접근이 더 늘어
- 캐시 미스·TLB 미스 가능성이 커질 수 있다.
하지만 이건 “주소 범위가 넓어져서 캐시가 좋아진다/나빠진다” 문제가 아니라:
같은 캐시 라인에 담기는 유효 데이터 밀도(footprint) 문제다.
4. 왜 32비트와 64비트로 ‘나뉘게’ 되었나: 근본 원인
4.1 데이터와 메모리 규모가 임계점을 넘었기 때문
과거에는 4GiB 수준의 주소 공간이 현실적으로 큰 문제를 만들지 않았다. 하지만 시간이 지나면서
- 서버/데스크탑/가상화 환경에서 메모리 규모 증가
- 애플리케이션이 다루는 데이터 증가(로그, DB, 캐시, 모델 등)
- 동시에 다수 프로세스/스레드 운영이 일반화
이런 환경에서는 32비트 주소 체계가 구조적으로 불리해졌다.
4.2 한 번 바꾸면 생태계 전체가 바뀌기 때문
ISA의 워드 크기/ABI/라이브러리/OS/드라이버는 한 덩어리로 움직인다.
그래서 업계는 “필요가 충분히 커졌을 때” 큰 전환(32 → 64)을 선택했고, 그 결과 64비트가 현대 표준이 되었다.
5. 결론
- 32비트: 포인터가 작아 메모리/캐시 효율이 좋아지는 경우가 있지만, 주소 공간과 현대 생태계에서 한계가 크다.
- 64비트: 큰 주소 공간과 64비트 연산/레지스터 확장으로 현대 워크로드에 적합하며, 그래서 표준이 되었다.
“32비트/64비트는 단순히 ‘RAM을 얼마나 쓰냐’가 아니라, CPU가 숫자와 주소를 다루는 기본 단위, 프로그램 바이너리 호환 규칙(ABI), 그리고 캐시 효율까지 엮여 있는 설계 선택이다. 결국 시대가 커진 책(데이터)을 감당하기 위해, 페이지 번호 체계(주소 폭)와 작업 방식(레지스터/ABI)이 함께 확장된 것이 64비트 전환의 본질이다.”